
AI가 고전 게임 둠(Doom)을 플레이합니다. 화면 이미지를 보는 대신 게임 상태를 텍스트가 담긴 데이터로 받아, 1초에 10번 판단을 내립니다.
이 데모를 만든 엔지니어는 AI에 초당 10번씩 질문을 보내도 괜찮을지 걱정했습니다. 막상 계산해 보니 비용은 시간당 7달러 남짓으로, 예상보다 낮았습니다. 9월 15일 TypeSafe AI가 새 모델 Jev를 발표하면서 공개한 데모입니다.
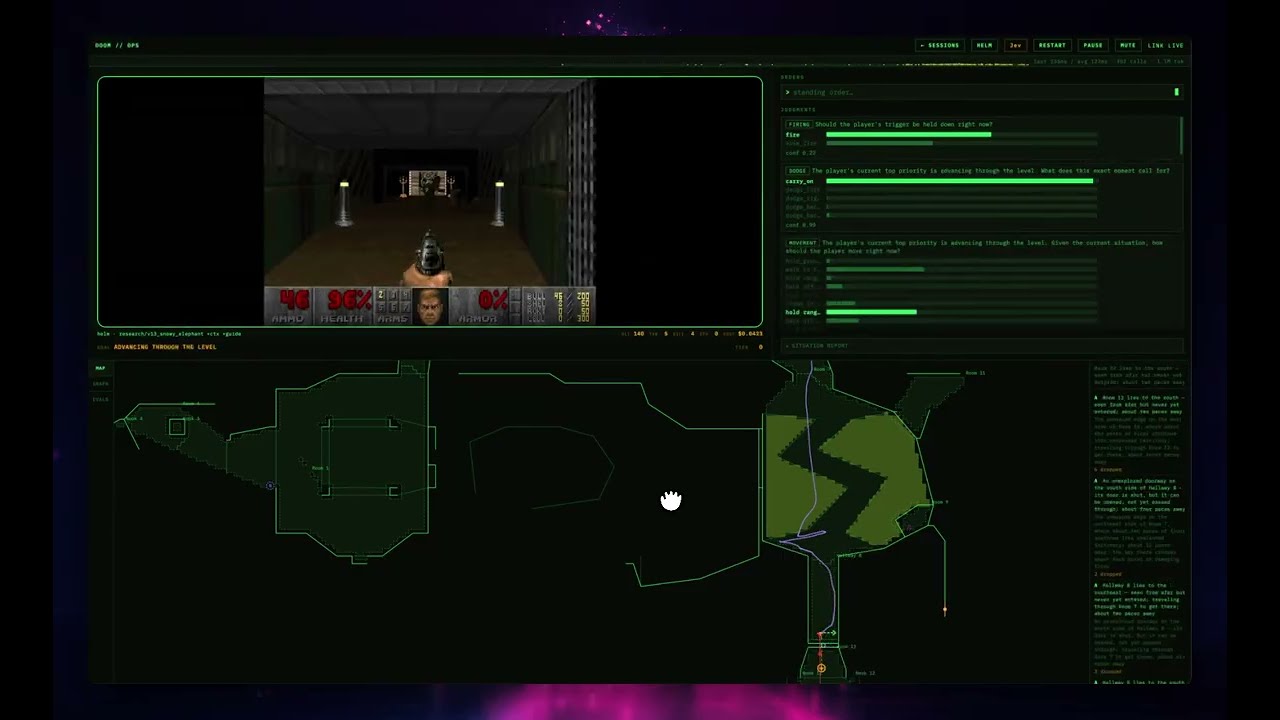
게임 실력을 자랑하려는 데모는 아니에요. TypeSafe도 발표문에서 이렇게 인정했거든요.
AI를 쓰지 않은 둠 봇이 더 잘할 수도 있습니다.원문: “A non-AI doom bot could play better”
출처: TypeSafe AI, Introducing System One Models & Jev (2026-09-15)
사람들이 주목한 건 속도와 비용이었습니다. ChatGPT나 Claude 같은 대형 언어 모델(LLM)은 답 하나를 내는 데 보통 몇 초가 걸립니다. 이런 모델로 1초에 10번 판단하는 봇을 만든다면 속도도 비용도 감당하기 어렵습니다.
반응은 게임 밖으로 빠르게 번졌습니다. 발표 엿새 뒤인 9월 21일, Spring 공식 블로그에 Jev를 Spring AI에 연결하는 커뮤니티 프로젝트가 소개됐습니다. 글쓴이가 직접 측정해 보니 질문 하나짜리 판정이 275ms(0.275초)에 끝났다고 합니다. 글의 결론은 이렇습니다.
모든 호출마다 검사를 둘 수 있을 만큼 저렴합니다. 일부만 골라 검사할 필요가 없습니다.원문: “Cheap enough to check every call. (…) You do not have to sample.”
출처: Christian Tzolov, Spring AI and TypeSafe Jev: Fast, Cheap, Structured Decisions, Spring 블로그 (2026-09-21)
같은 날, 한국어 서비스에 쓸모가 큰 실험도 하나 공개됐습니다. Jev와 똑같은 호출 방식을 Upstage의 새 경량 모델 Solar Mini 4로 재현하고, 한국어와 영어 문항 400건으로 두 모델을 비교한 solar-mini4-jev 저장소입니다. 비교 결과는 뒤에서 자세히 다룹니다.
게임 봇, 프레임워크 연동, 재현 실험까지 불과 일주일 사이에 벌어진 일이에요. 세 사례는 같은 질문을 던지고 있어요. AI의 판단이 이 정도로 빠르고 저렴해지면 무슨 일이 생길까요? 그리고 한국어로 서비스하는 우리는 그 변화를 어디서부터 경험할 수 있을까요?
판정이 저렴해지면, 판정은 오히려 늘어납니다
Jev라는 이름에 답이 들어 있습니다. TypeSafe는 이 모델의 이름을 19세기 영국 경제학자 윌리엄 스탠리 제번스(William Stanley Jevons)에게서 따왔습니다.
제번스는 증기기관의 효율이 좋아지자 석탄 소비가 줄기는커녕 오히려 늘어났다는 점을 지적했습니다. 석탄을 덜 쓰고도 같은 일을 할 수 있게 되자, 예전에는 수지가 맞지 않던 곳까지 증기기관이 퍼졌기 때문입니다. 효율이 오르면 사용량이 늘어나는 이 현상을 흔히 '제번스 역설'이라고 부릅니다.
TypeSafe는 AI도 같은 길을 걸을 것이라고 봅니다.
지능의 비용이 10분의 1로 떨어질 때마다, 쓸 수 있는 곳은 그보다 훨씬 큰 폭으로 늘어납니다.원문: “Every order of magnitude drop in the cost of intelligence unlocks orders of magnitude more use cases.”
출처: TypeSafe AI, Introducing System One Models & Jev (2026-09-15)
이 말을 개발 현장에 대입해 보면 이해가 쉽습니다. 서비스에 AI를 연결해 본 개발자라면 LLM 호출의 상당수가 사실은 '판정', 즉 정해진 답 가운데 하나를 고르는 일이라는 점을 잘 알고 있을 것입니다.
- 이 문의를 어느 팀에 넘길까?
- 모델이 쓴 답변이 근거 문서와 맞을까?
- 사용자 입력에 악의적인 지시가 섞여 있을까?
코드로 치면 if 문 하나에 해당하는 결정입니다. 그런데 지금까지는 이 if 문 하나를 위해 몇 초씩 걸리는 LLM을 호출해야 했습니다. 비용과 시간이 부담스러우니 전체 중 일부만 골라 검사하거나, 아예 검사를 건너뛰는 경우가 많았습니다.
판정이 0.3초 안팎에, 거의 무시할 수 있는 비용으로 끝난다면 이야기가 달라집니다. 모든 답변을 검증하고, 모든 문의를 분류하고, 모든 로그를 판정할 수 있게 됩니다. Spring 블로그 글이 "일부만 골라 검사할 필요가 없다"고 말한 것도 바로 이 지점이에요.
그렇다면 Jev는 어떤 구조이길래 이렇게 빠르고 저렴할 수 있을까요?
Jev는 어떻게 판정하나요
비결은 글을 쓰지 않는 데 있습니다. TypeSafe는 Jev를 'System One 모델'이라고 부릅니다. 심리학자 대니얼 카너먼이 구분한 두 가지 사고방식 가운데, 빠르고 직관적인 판단(System 1)만 전담한다는 뜻입니다. 느리게 따져 보는 추론(System 2)과 글쓰기는 기존 LLM의 몫으로 남겨 둡니다.
시험 답안으로 비유하면 차이가 분명해져요. 일반 LLM은 서술형 답안을 쓰는 학생입니다. 무엇이든 답할 수 있지만 쓰는 데 시간이 걸리고, 채점하는 쪽은 답안을 끝까지 읽어야 결론을 찾을 수 있습니다.
Jev는 객관식 답안지에 마킹만 하는 학생에 가깝죠. 서술은 못 하는 대신 빠르고, 답이 정해진 칸 밖으로 나가지 않습니다.
| 구분 | 일반 LLM | Jev (System One) |
|---|---|---|
| 답하는 방식 | 문장을 한 단어씩 생성 | 정해진 형식의 값을 한 번에 출력 |
| 잘하는 일 | 설명, 글쓰기, 코드 작성 | 분류, 예/아니오 판단, 점수 매기기 |
| 할 수 없는 일 | 없음(대신 느리고 비용이 큼) | 문장 생성, 대화, 코드 작성 |
Jev에 넣는 입력은 두 가지뿐입니다. 판단의 근거가 되는 상태(state), 그리고 그 상태에 대해 묻는 질문 목록(questions)입니다. 둠 데모라면 게임 상황이 상태에 해당합니다. 질문은 아래 세 가지 형식 가운데 하나로 정합니다.
| 형식 | 묻는 것 | 돌려받는 값 |
|---|---|---|
| noul | 예/아니오 질문 | 예일 확률(0~1) |
| choice | 여러 선택지 중 하나 | 고른 선택지와 선택지별 확률 |
| score | 단계형 평가 | 0부터 N-1 사이의 점수 |
실제 요청은 이런 모양입니다. 결제 장애 상황을 상태로 주고, 온콜 담당자(장애 대응을 맡은 당번 개발자)를 호출할지, 어느 팀에 넘길지를 묻습니다. 사용할 모델(jev-latest)을 함께 지정해 /v1/systemone 주소로 보냅니다.
{
  "state": "결제 성공률이 12%로 떨어졌다.",
  "questions": {
    "urgent": {
      "type": "noul",
      "instructions": "온콜 담당자를 즉시 호출해야 하는가?"
    },
    "team": {
      "type": "choice",
      "instructions": "어느 팀이 처리해야 하는가?",
      "criteria": { "billing": "결제·환불", "technical": "오류·장애", "sales": "견적·도입" }
    }
  }
}
응답에는 질문마다 형식에 맞는 값이 담깁니다. urgent에는 0.97 같은 확률 하나가, team에는 고른 선택지와 선택지별 확률이 돌아오는 식입니다. 확률 0.97은 "97% 정도 확신한다"로 읽으면 됩니다. 문장이 아니라 값이 오기 때문에, 응답을 해석하다가 형식이 어긋나 오류가 날 일도 없습니다.
이 구조를 바탕으로 TypeSafe가 내세운 수치는 다음과 같습니다.
- 응답 시간 70~500ms(0.07~0.5초)
- 입력 100만 토큰당 0.042달러, 출력은 무료
- 자체 워크플로 평가에서 프론티어 LLM보다 193.6배 빠르고 444.6배 저렴
모두 회사가 발표한 수치이고, 회사 스스로 단서도 달았습니다. 출시 발표문에서 이 배수는 실제 환경에서 얻을 수 있는 개선 폭의 상단일 것이라고 밝혔고, 가격이 보조금으로 유지되는 것이 아님을 증명할 수는 없다고도 적었습니다.
한계도 문서에 분명히 적혀 있습니다. TypeSafe 공식 문서에 따르면 Jev는 텍스트를 생성하지 못하고, 코드 작성이나 대화도 하지 못합니다. 영어에서 가장 정확하며 한국어·중국어·일본어는 같은 수준을 보장하지 않습니다. 숫자 세기와 날짜 비교에도 약하다고 밝혀 두었습니다.
이 한계 목록 가운데, 한국어로 서비스하는 입장에서 그냥 넘길 수 없는 항목이 두 가지 있습니다.
한국어 서비스에서 걸리는 두 가지
첫째는 한국어 정확도입니다. Jev는 영어에서 가장 정확하고, 한국어는 같은 수준을 보장하지 않는다고 제공사 스스로 밝혔습니다. 판정 모델의 가치는 결국 판정이 맞느냐에 달려 있습니다. 한국어 고객의 문의를 분류하는 서비스라면 가장 중요한 부분에서 확신을 갖기 어렵습니다.
둘째는 판정 다음 단계입니다. 고객 문의를 처리하는 흐름을 떠올려 보겠습니다. 문의가 들어오면 긴급도와 담당 팀을 판정하고, 그 결과에 맞춰 1차 답변을 보냅니다.
Jev를 쓰면 앞 단계인 판정은 빨라집니다. 하지만 답변은 Jev가 쓸 수 없으니 답변용 LLM을 따로 연결해야 합니다. 결국 판정 모델과 답변 모델, API 키 두 개, 청구서 두 장을 따로 관리하게 됩니다.
덧붙여 Jev는 아직 얼리 액세스 단계라서 대기자 명단에 등록하고 차례를 기다려야 쓸 수 있습니다.
정리하면 한국어 서비스에 필요한 모델의 조건은 세 가지예요. Jev처럼 판정하고, 한국어에 강하고, 판정이 끝나면 글도 쓸 수 있어야 하죠. 도입에서 소개한 재현 저장소가 시험한 Solar Mini 4가 바로 이 조건에 맞는 모델이에요.
그래서 Solar Mini 4
Upstage가 9월 22일 출시한 Solar Mini 4는 세 가지 조건에 하나씩 답합니다.
- 판정: 전체 350억 개 파라미터 가운데 30억 개만 활성화해 동작하는 경량 모델입니다. 파라미터 일부만 쓰기 때문에 응답이 빠르고 호출 비용이 낮아, 자주 반복되는 판정에 맞습니다.
- 한국어: Upstage 공식 문서에 따르면 한국어·영어·일본어를 지원합니다.
- 글쓰기: Jev와 달리 일반 채팅 모델입니다. 판정 질문에 답한 뒤 같은 모델에 답변 작성까지 맡길 수 있습니다. 정해진 JSON 형식으로 답하는 구조화 출력과 도구 호출도 지원합니다.
그렇다면 판정 성능은 Jev와 비교해 어느 정도일까요? 재현 저장소는 Solar Mini 4를 Jev와 같은 형식으로 호출하도록 구현하고, 테스트 문항 400건에서 두 모델을 비교했습니다.
채점 대상 447개 항목에서 Solar Mini 4는 7개, Jev는 26개를 틀렸습니다. 한국어 문항만 따로 봐도 Solar Mini 4가 앞섰습니다. 속도는 반대였습니다. 호출 한 번에 걸린 평균 시간은 Jev가 0.38초, Solar Mini 4가 1.21초로 약 3.2배 차이였습니다.
이 결과를 읽을 때는 세 가지를 함께 봐 주세요.
- 정답 기준은 사람이 아니라 Grok 4.6을 채점자로 삼은 기준표에서 나왔습니다.
- Solar Mini 4 쪽 점수는 모델만의 성능이 아닙니다. 학습용 문항 400건으로 다듬은 프롬프트와 보정 코드까지 포함된 결과입니다.
- 테스트 400건 가운데 한국어 문항은 70건입니다.
그래서 이 수치는 "어느 모델이 더 똑똑한가"보다 "Solar Mini 4로 Jev 방식의 판정을 충분히 구현할 수 있는가"에 대한 근거로 보는 편이 정확합니다.
이제 남은 질문은 이 모델을 서비스에 어떻게 연결하느냐예요.
그래서 LLM Router로 연결합니다
Solar Mini 4는 9월 22일부터 LLM Router에서 바로 호출할 수 있습니다. LLM Router로 연결하면 좋은 점은 세 가지입니다.
- 코드 변경이 적습니다. LLM Router는 OpenAI와 같은 호출 방식을 지원합니다. 이미 OpenAI SDK를 쓰고 있다면 접속 주소(
base_url)와 모델 이름만 바꾸면 됩니다. - 키 하나로 여러 모델을 씁니다. 판정은 Solar Mini 4로 하고, 더 깊은 추론이 필요한 문의만 상위 모델로 넘기는 구성을 같은 API 키, 같은 청구서 안에서 만들 수 있습니다. 앞에서 짚은 "모델 두 개, 키 두 개, 청구서 두 장" 문제가 여기서 풀립니다.
- 판정에 맞는 옵션이 있습니다. 비슷한 질문에 이전 답을 재사용하는 시맨틱 캐시를 호출 단위로 끌 수 있습니다. 판정에서 왜 이 옵션이 중요한지는 4단계에서 설명합니다.
이 글에서 만들 구성을 그림으로 먼저 보면 다음과 같습니다.
이제 직접 만들어 보겠습니다. 목표는 Jev와 같은 형식(상태와 질문)을 넣으면 Solar Mini 4가 판정하고, 검증을 거친 값을 돌려받는 함수 하나입니다.
시작하기 전에
- Python과 OpenAI 공식 SDK가 필요합니다.
pip install openai로 설치합니다. - LLM Router API 키를 콘솔에서 발급받습니다. 키는
sk-cafe24-로 시작합니다. - Solar Mini 4의 모델 ID는
upstage/solar-mini4입니다.
1단계: 연결 설정
접속 주소를 LLM Router로, 모델을 Solar Mini 4로 지정합니다. 실제 서비스에서는 API 키를 코드에 직접 적지 말고 환경 변수로 관리하세요.
import json
from openai import OpenAI

client = OpenAI(base_url="https://llm-router.cafe24.com/api/v1", api_key="sk-cafe24-...")
MODEL = "upstage/solar-mini4"
2단계: 질문을 모델이 이해하는 설명으로 바꾸기
Solar Mini 4는 Jev의 질문 형식(noul, choice, score)을 따로 학습한 모델이 아닙니다. 그래서 질문 하나하나를 "무엇을, 어떤 범위의 값으로 답하라"는 문장으로 풀어서 전달합니다. choice 질문에는 선택지마다 설명을 붙이는데, 뒤에서 보겠지만 이 설명이 정확도를 크게 좌우합니다.
def describe(name, q):
    if q["type"] == "noul":
        return f"- {name}.noul: '{q['instructions']}'가 참일 확률(0~1)"
    if q["type"] == "choice":
        opts = ", ".join(f"{k}({v})" for k, v in q["criteria"].items())
        return (f"- {name}.choice: {q['instructions']} 반드시 다음 키 중 하나: {opts}. "
                f"{name}.probabilities도 이 키만 쓰고 합은 1")
    levels = " / ".join(f"{i}={d}" for i, d in enumerate(q["criteria"]))
    return f"- {name}.score: {q['instructions']} 0~{len(q['criteria']) - 1} 숫자 ({levels})"
3단계: 답의 모양을 JSON 스키마로 정하기
JSON 스키마는 "응답이 어떤 구조여야 하는지"를 적은 설계도입니다. 예를 들어 choice 질문이라면 choice와 probabilities 두 항목이 있어야 하고, choice에는 허용된 값 목록(enum)에 있는 값만 들어가야 한다고 적어 둡니다.
def schema_for(questions):
    props = {}
    for name, q in questions.items():
        if q["type"] == "noul":
            p = {"noul": {"type": "number"}}
        elif q["type"] == "choice":
            p = {"choice": {"type": "string", "enum": list(q["criteria"])},
                 "probabilities": {"type": "object", "additionalProperties": {"type": "number"}}}
        else:
            p = {"score": {"type": "number"}}
        props[name] = {"type": "object", "properties": p,
                       "required": list(p), "additionalProperties": False}
    return {"type": "object", "properties": props,
            "required": list(props), "additionalProperties": False}
4단계: 판정 요청 보내기
2단계의 설명은 시스템 프롬프트로, 3단계의 스키마는 response_format으로 전달합니다. 눈여겨볼 옵션은 두 가지입니다.
temperature=0: 같은 입력에는 최대한 같은 답이 나오도록 무작위성을 끕니다. 판정에는 일관성이 중요하기 때문입니다.extra_body의cache설정: LLM Router의 시맨틱 캐시를 끄는 옵션입니다. 시맨틱 캐시는 뜻이 비슷한 질문에 이전 답을 재사용해 비용을 줄이는 기능인데, 판정에서는 문장이 비슷해도 결론은 달라야 하는 경우가 많습니다. "결제가 두 번 됐어요"와 "결제가 안 돼요"는 비슷해 보여도 전혀 다른 문의잖아요.
def judge(state, questions):
    system = "You are a calibrated decision engine. Output JSON only.\n" + "\n".join(
        describe(n, q) for n, q in questions.items())
    res = client.chat.completions.create(
        model=MODEL,
        temperature=0,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": f"STATE: {state}"}],
        response_format={"type": "json_schema", "json_schema": {
            "name": "judge", "strict": True, "schema": schema_for(questions)}},
        extra_body={"cache": {"semantic": False}},
    )
    return validate(json.loads(res.choices[0].message.content), questions)
5단계: 돌아온 값을 코드에서 검증하기
마지막 안전장치입니다. 확률은 0~1 범위로, 점수는 정해진 단계 안으로 맞춥니다. choice에서는 허용하지 않은 선택지를 버리고 확률 합을 다시 1로 맞춥니다. 스키마까지 보냈는데 왜 한 번 더 검증하는지는 6단계 뒤에서 실측 결과로 설명합니다.
def validate(raw, questions):
    out = {}
    for name, q in questions.items():
        a = raw[name]
        if q["type"] == "noul":
            out[name] = {"noul": min(max(float(a["noul"]), 0.0), 1.0)}
        elif q["type"] == "choice":
            keys = list(q["criteria"])
            probs = {k: float(a.get("probabilities", {}).get(k, 0)) for k in keys}
            total = sum(probs.values()) or 1.0
            probs = {k: round(v / total, 3) for k, v in probs.items()}
            choice = a["choice"] if a["choice"] in keys else max(probs, key=probs.get)
            out[name] = {"choice": choice, "probabilities": probs}
        else:
            top = len(q["criteria"]) - 1
            out[name] = {"score": min(max(float(a["score"]), 0), top)}
    return out
6단계: 실행하기
고객 문의 하나를 넣고 긴급도, 담당 팀, 심각도를 한 번에 물어봅니다. 호출하는 방식은 Jev를 쓸 때와 거의 같습니다.
questions = {
    "urgent": {"type": "noul", "instructions": "온콜 담당자를 지금 즉시 호출해야 한다"},
    "team": {"type": "choice", "instructions": "이 문의를 처리할 담당 팀은?",
             "criteria": {"billing": "결제·환불·중복청구·세금계산서",
                          "technical": "오류·장애·5xx·API·연동 문제",
                          "sales": "요금제 견적·도입·계약 문의",
                          "account": "로그인·계정·권한·비밀번호"}},
    "severity": {"type": "score", "instructions": "심각도는?",
                 "criteria": ["사소함·단순 문의", "경미", "보통", "심각", "전면 장애·보안 사고"]},
}
print(judge("API 호출할 때마다 502가 떠서 서비스 전체가 멈췄습니다.", questions))
2026년 9월 23일에 실제로 실행한 결과입니다. 긴급도 1.0(즉시 호출), 담당 팀 technical, 심각도 4(전면 장애)로 기대한 판정과 정확히 일치했습니다.
{
  "urgent": { "noul": 1.0 },
  "team": {
    "choice": "technical",
    "probabilities": { "billing": 0.0, "technical": 1.0, "sales": 0.0, "account": 0.0 }
  },
  "severity": { "score": 4.0 }
}
서비스에서는 이 값을 조건문에 바로 연결하면 됩니다. 예를 들어 urgent가 0.5 이상이면 온콜 알림을 보내고, team 확률이 0.6 미만으로 애매하면 사람이 검토하는 대기열로 넘기는 식입니다. 기준값은 서비스 성격에 맞게 조정하세요.
스키마를 보냈는데 왜 다시 검증해야 할까요
스키마까지 보내는데 5단계의 validate 함수가 꼭 필요할까요? 확인하려고 한국어 고객 문의 24건을 준비해 두 가지 방식으로 판정을 요청해 봤습니다. 정답은 작성자가 직접 정했습니다.
- 방식 1: 선택지를 JSON 스키마의
enum으로만 지정하고, 선택지 설명은 넣지 않았습니다. - 방식 2: 위 코드처럼 선택지마다 설명을 프롬프트에 함께 적었습니다.
방식 1에서는 허용 값 목록을 지정했는데도 24건 모두 확률 분포에 support, engineering처럼 지정하지 않은 선택지가 섞여 나왔습니다. 502 오류로 서비스가 멈췄다는 문의와 모든 리전에서 503 오류가 난다는 문의까지 sales(영업팀)로 분류했을 정도입니다. 측정 시점에 LLM Router를 거친 호출에서 스키마는 응답 구조를 안내하는 역할에 그쳤고, 값까지 강제하지는 않았습니다.
방식 2는 결과가 달랐습니다. 지정하지 않은 선택지는 한 건도 나오지 않았습니다. 긴급 여부 24건과 심각도 24건(1단계 오차 허용)을 모두 맞혔고, 같은 코드를 두 번 실행해도 결과는 같았습니다. 응답 시간은 중앙값 기준 1.0~1.1초였습니다.
담당 팀은 24건 중 21건을 맞혔습니다. 틀린 3건은 API 키 유출, 2단계 인증 기기 분실, 초대 메일 미수신 문의입니다. 작성자는 셋 다 계정 담당(account) 팀으로 봤고, 모델은 기술 담당(technical) 팀으로 분류했습니다. 두 팀의 경계에 걸친 문의라서 기준을 어떻게 정하느냐에 따라 판단이 갈릴 수 있는 사례입니다.
이런 문의가 자주 들어온다면 선택지 설명에 "API 키 관리는 account"처럼 기준을 한 줄 더 적어 두세요. 모델은 선택지 설명을 근거로 판단하므로, 기준을 적어 두는 것만으로도 경계에 걸친 문의에서 기댈 근거가 생깁니다.
코드를 다듬는 과정에서 겪은 시행착오도 하나 공유할게요. 처음에는 스키마 없이 "이런 구조로 답하라"는 예시 JSON을 프롬프트에 넣었습니다.
그랬더니 모델이 예시에 적어 둔 값(0.0)을 그대로 따라 써서, 502 장애 문의의 긴급도를 0.0으로 판정했습니다. 예시 값을 null로 바꾸자 이번에는 null이 그대로 돌아왔습니다.
여러 방식을 시험해 보니 구조는 스키마로, 의미는 선택지 설명으로 전달하고, 값은 코드로 검증하는 조합이 가장 안정적이었습니다.
물론 24건은 작은 표본입니다. 실제 서비스에 적용하기 전에는 실제 문의 기록으로 정답을 만들어, 같은 방식으로 한 번 더 측정해 보세요.
판정이 끝나면 같은 모델로 답변까지
이제 Jev로는 할 수 없던 다음 단계입니다. 판정 결과를 받은 뒤, 같은 upstage/solar-mini4에 답변 작성을 요청하면 됩니다.
"어제 결제가 두 번 빠져나갔어요. 환불 가능한가요?"는 앞의 실측에서 billing 팀, 긴급도 낮음으로 판정된 문의입니다. 같은 문의로 정중한 1차 답변을 세 문장으로 요청하면서 확인되지 않은 사실은 약속하지 말라는 조건을 붙였더니 이런 답이 돌아왔습니다.
안녕하세요, 고객님. 문의해 주셔서 감사합니다. 결제 내역 확인을 위해 정확한 결제 일시와 금액을 알려주시면 확인 후 환불 가능 여부를 안내해 드리겠습니다. 확인 결과에 따라 필요한 절차를 안내해 드릴 수 있도록 최선을 다하겠습니다.생성: upstage/solar-mini4, LLM Router 경유 (2026-09-23 실행, 편집 없이 그대로 수록)
"환불해 드리겠습니다"처럼 확인되지 않은 약속은 하지 않았습니다. 고객이 해야 할 다음 행동(결제 일시와 금액 전달)도 분명하게 안내했습니다. 문의 세 건 기준으로 답변 작성에는 0.6~2.3초가 걸렸습니다. 판정과 답변이 같은 모델, 같은 API 키, 같은 청구서 안에서 끝납니다.
더 깊은 추론이 필요한 문의만 상위 모델로 넘기고 싶다면, 판정 결과를 조건으로 쓰면 됩니다. 예를 들어 심각도가 3 이상일 때만 더 큰 모델을 호출하는 식입니다. 모델을 하나 더 연결해 출력을 거르는 방법은 모델 체이닝 글에서, 작업별로 모델을 고르는 기준은 태스크별 모델 선택 전략에서 자세히 다뤘습니다.
한국어라면 왜 Solar Mini 4인가요
Jev 방식의 판정을 한국어 서비스에 적용한다고 가정하고, 두 모델을 나란히 놓아 보겠습니다.
| 비교 항목 | Jev | Solar Mini 4 (LLM Router) |
|---|---|---|
| 한국어 | 영어 최적, 한국어 수준은 보장 안 함 | 한국어·영어·일본어 공식 지원 |
| 판정 뒤 답변 작성 | 불가, 별도 LLM 필요 | 같은 모델로 가능 |
| 사용 시작 | 얼리 액세스 대기 | LLM Router에서 바로 호출 |
| API 키와 청구서 | 판정용·답변용 따로 | 키 하나, 청구서 하나 |
| 호출당 평균 지연 | 0.38초 | 1.21초 |
속도만 보면 Jev가 빠릅니다. 하지만 한국어 서비스에서 판정 모델에 먼저 요구되는 건 한국어 판정이 맞느냐입니다. 앞의 비교에서 한국어 문항 정확도는 Solar Mini 4가 더 높았고, 판정이 끝난 뒤의 답변 작성까지 같은 모델이 이어서 처리합니다. 0.8초 남짓의 차이를 감수하면 한국어 정확도와 답변 작성, 즉시 사용까지 한 번에 얻는 셈이죠. 한국어로 Jev 방식의 판정을 쓰려면 Solar Mini 4가 더 잘 맞는 선택이에요.
다시 둠 이야기로: 여러분의 판정을 오늘 시작하는 방법
처음의 둠 봇으로 돌아가 볼게요. 둠 봇은 게임을 잘하지 못했지만, 1초에 10번 판단해도 부담이 없는 비용을 보여줬습니다. Spring 블로그 글은 모든 호출마다 검사를 둘 수 있다고 했고, 재현 저장소는 같은 판정을 Solar Mini 4로도 해낼 수 있다는 걸 보여줬죠.
이제 도입에서 던진 두 질문에 답할 수 있습니다. 첫 번째 질문의 답은 제번스가 석탄에서 본 것과 같습니다. 판단이 빠르고 저렴해지면 판단을 쓰는 곳은 줄지 않고 늘어납니다. 비용 때문에 일부만 골라 하던 검사와 분류가 모든 호출로 넓어지고, 코드 안의 if 문 자리에 AI의 판정이 들어갑니다.
두 번째 질문의 답은 LLM Router입니다. 한국어 서비스라고 이 변화를 기다릴 필요는 없어요. Jev의 얼리 액세스 차례를 기다리지 않아도, Solar Mini 4는 LLM Router에서 이미 호출할 수 있습니다. 필요한 것은 API 키 하나와 이 글의 코드뿐이고, 순서는 세 단계입니다.
- LLM Router 콘솔에서 API 키를 발급받으세요.
- 1~5단계 코드를 복사하고,
questions를 여러분 서비스의 판정 기준으로 바꾸세요. 문의 분류, 리뷰 감정 판정, 답변 검수처럼 지금 사람이 하거나 건너뛰고 있는 판단이면 무엇이든 됩니다. - 실제 데이터 몇 건으로 판정해 보고, 결과가 기대와 맞으면 같은 키로 답변 작성까지 연결하세요.
둠 봇이 1초에 10번 판단했듯, 여러분의 서비스도 들어오는 모든 문의를 판정할 수 있어요. 첫 판정은 LLM Router에서 바로 경험해 보세요. https://llm-router.cafe24.com
자주 묻는 질문
Jev와 일반 LLM은 무엇이 다른가요?
일반 LLM은 단어를 하나씩 이어 붙여 문장을 만듭니다. Jev는 문장을 만들지 않고 미리 정한 형식(예/아니오 확률, 선택지, 점수)으로만 답합니다. 그 대신 텍스트 생성, 코드 작성, 대화는 하지 못합니다.
Jev라는 이름은 어디서 왔나요?
19세기 영국 경제학자 윌리엄 스탠리 제번스에게서 따왔습니다. 증기기관 효율이 좋아지자 석탄 소비가 오히려 늘었던 것처럼, AI 판단 비용이 떨어지면 AI를 쓰는 곳이 크게 늘어난다는 뜻을 담았습니다.
Solar Mini 4로 Jev와 같은 판정을 할 수 있나요?
네. 같은 상태·질문 형식으로 판정하도록 구성할 수 있습니다. 공개 저장소의 비교에서 Solar Mini 4는 한국어 문항을 포함한 정확도에서 Jev보다 높았고, 속도는 Jev가 더 빨랐습니다. 여기에 판정 뒤 답변 작성까지 같은 모델로 처리할 수 있어, 한국어 서비스에서 Jev 방식을 쓰기에 더 잘 맞습니다.
LLM Router에서 Solar Mini 4의 모델 ID는 무엇인가요?upstage/solar-mini4입니다. OpenAI 호환 SDK에서 base_url을 https://llm-router.cafe24.com/api/v1로 지정하고 이 모델 ID로 호출하면 됩니다.
JSON 스키마를 지정하면 출력 형식이 보장되나요?
2026년 9월 23일 측정에서는 스키마를 지정해도 허용하지 않은 값이 섞여 나왔습니다. 선택지 설명을 프롬프트에 명시하고, 응답은 코드에서 한 번 더 검증하는 방식을 권합니다.